統計・機械学習

統計・機械学習

有意差って何?そんなに凄いものなの?【統計のモヤモヤ #6】

はじめに よく研究データなどで、有意差あり!とお墨付きのように書かれているのをみることがあります。有意差という言葉はよく見るものの、その意味はかなり複雑で直感的に理解できるものではなかったりします。 本記事では基本的な検定の方...
統計・機械学習
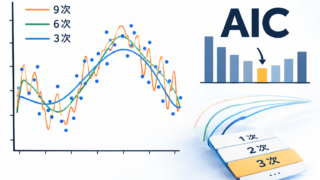
【フィッティング #3】情報量基準によるフィット関数の次数選択

はじめに 前回まで10点データに対して、次数を落とさず9次式を使ってカーブフィッティング(曲線近似)を行いました。今回は意地を張らずに次数を落としてフィッティング行います。問題は次数を幾つに落とすか?であり、情報量基準(AIC,Ak...
統計・機械学習

【フィッティング #2】どうしても9次式でフィッティングしたい!

はじめに 前回記事にて、データ点が10点の時に9次式でカーブフィッティング(曲線近似)を行いました。当然ながら、過学習となりNGでした。それでもやはり9次式で上手くフィットしてみせたい!!と思ったので、フィット方法を修正して再度9次...
統計・機械学習

【フィッティング #1】10点のデータなら9次式でフィッティングすればいいじゃない!

はじめに 修士時代に実験データ解析をやり始めた頃、どれだけ綺麗にカーブフィッティング(曲線近似)できるか、を常に考えていました。 その時ふと思いつきます。「10点データであれば、9次式でフィットすれば完全にフィットできるのでは...
統計・機械学習

「95%信頼区間」の95%は確率を表していないという嘘みたいな話【統計のモヤモヤ #5】

はじめに 何かの測定結果に対して、95%信頼区間が併記されることがあります。 例えば、1.00±0.05という結果が得られたとき、「真の値が0.95〜1.05の間にある確率が95%」と理解するのではないでしょうか。 実は...
統計・機械学習

データは正規分布していないのに、なぜ正規分布を使うのか?【統計のモヤモヤ #4】

はじめに 実験データの解析などで正規分布を仮定した見積もりや議論によく出くわします。よく分からないからとりあえず正規分布としておこう、ってしたことありませんか?僕は何度も数えきれないほどあります。そしてあまり人からつっこまれないし、...
統計・機械学習

なぜ分散は n−1 で割るのか?頻度主義からNumPyのddofまで【統計のモヤモヤ #3】

はじめに 大学の統計の授業で分散はn-1で割ると習いました。(nはデータ点数)なぜnではなくn-1で割るのでしょうか? この記事ではn-1で割る理由、実際のデータ解析での考え方、NumPyを使って求めるときにはどうしたらいいか...
統計・機械学習

決定係数R²が低いとフィッティングしてはいけない?実例で理解するR²の本当の意味【統計のモヤモヤ #2】

はじめに  実験データを元にカーブフィッティング(曲線近似)を行い、グラフを描いたときに決定係数 $R^2$(R2、coefficient of determination)がよく併記されています。もし $R^2 = 0.99$ の...
光学

スペックル(Speckle)の統計的性質とクロスオーバー【スペックル:第4回】

はじめに  前回までに3回にわたってスペックル(speckle)で生じる光の分布の計算方法を詳細に解説しました。実際にスペックルの影響を考える際にはここまで詳細に扱う必要性に迫られることは少なく、スペックルの統計的な性質を押さえてお...
統計・機械学習

測定値の比はなぜ歪むのか?直感が崩れる統計の話【統計のモヤモヤ #1】

はじめに  光学実験でパワー測定はよくやりますが、2個の異なる条件で取得したパワーの比率を計算するときは、得られる値のばらつきの扱いに注意が必要です。この記事では、どういう事が起こるかをpythonで可視化して理解します。対処方法も...
タイトルとURLをコピーしました