はじめに
修士時代に実験データ解析をやり始めた頃、
どれだけ綺麗にカーブフィッティング(曲線近似)できるか、を常に考えていました。
その時ふと思いつきます。
「10点データであれば、9次式でフィットすれば完全にフィットできるのではないか?」
データ点10個に対して、9次式は係数が10個あるので、原理的にはデータ点を完全に通せるのではないか?
似たようなアイディアを一度は考えたことあるんじゃないでしょうか?
この記事で深堀りしてみます。
9次式フィッティングをやってみる
sin関数に乱数を乗せてダミーデータを作成してみます。
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)

# 10個のデータ点
x = np.linspace(0, 2*np.pi, 10)

# 真の関数
y_true = np.sin(x)

# 実験誤差を想定したノイズ
noise = np.random.normal(0, 0.3, size=x.shape)

# 観測データ
y = y_true + noiseフィッティングを行ってみます。
coef = np.polyfit(x, y, deg=9)

# フィッティング関数
fitting_func = np.poly1d(coef)


# グラフ化
x_plot = np.linspace(0, 2*np.pi, 500)

plt.scatter(x, y, label="Data")
plt.plot(x_plot, fitting_func(x_plot), label="9th-order polynomial")

plt.xlabel("x")
plt.ylabel("y")
plt.legend()
plt.show()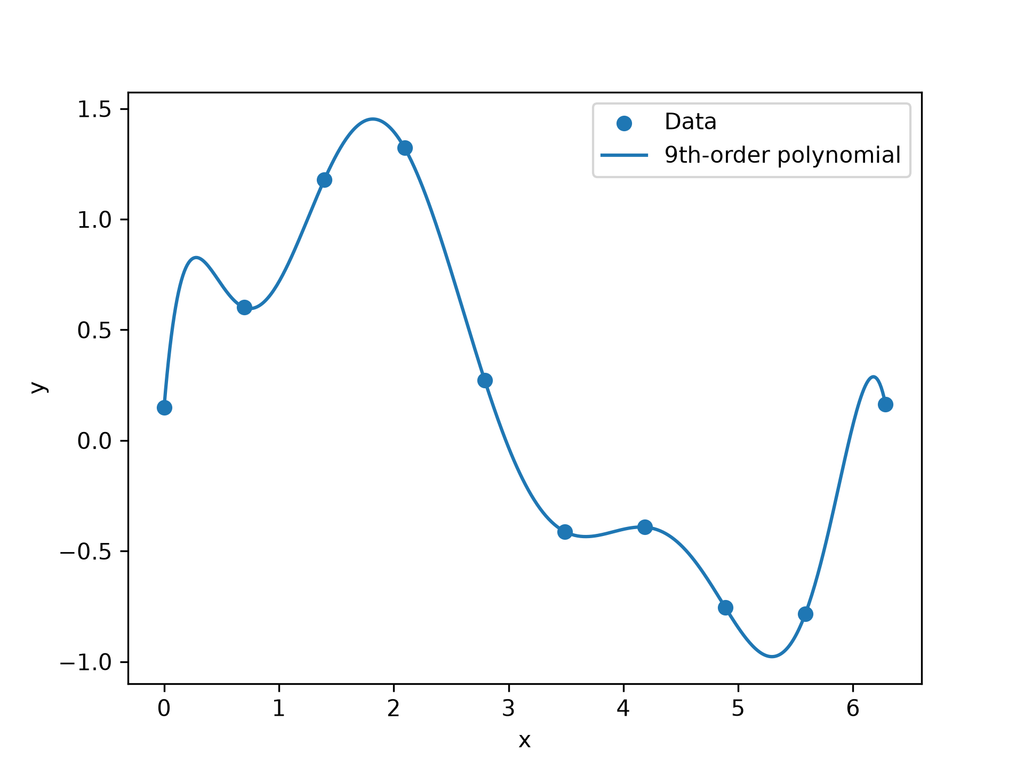
確かにデータ点をすべて通っています!
…ぐにゃぐにゃしているのが気になります。
$R^2=1$!!!
決定係数$R^2$も求めてみます。
y_fit = fitting_func(x)

ss_res = np.sum((y - y_fit)**2)
ss_tot = np.sum((y - np.mean(y))**2)

r2 = 1 - ss_res / ss_tot

print("R² =", r2)R² = 1.0
$R^2$は1です!
全てのデータ点を通ると、決定係数$R^2$は1となるのです!
9次式フィッティングがダメな理由
確かにすべてのデータ点を通せましたが、こんなことをしている論文は見たことありませんし直感的にもダメな気がします。
外挿してみる
先ほどのグラフの範囲は$(0,2\pi)$だったので、フィット結果の範囲を$(0,3\pi)$まで広げてみます。
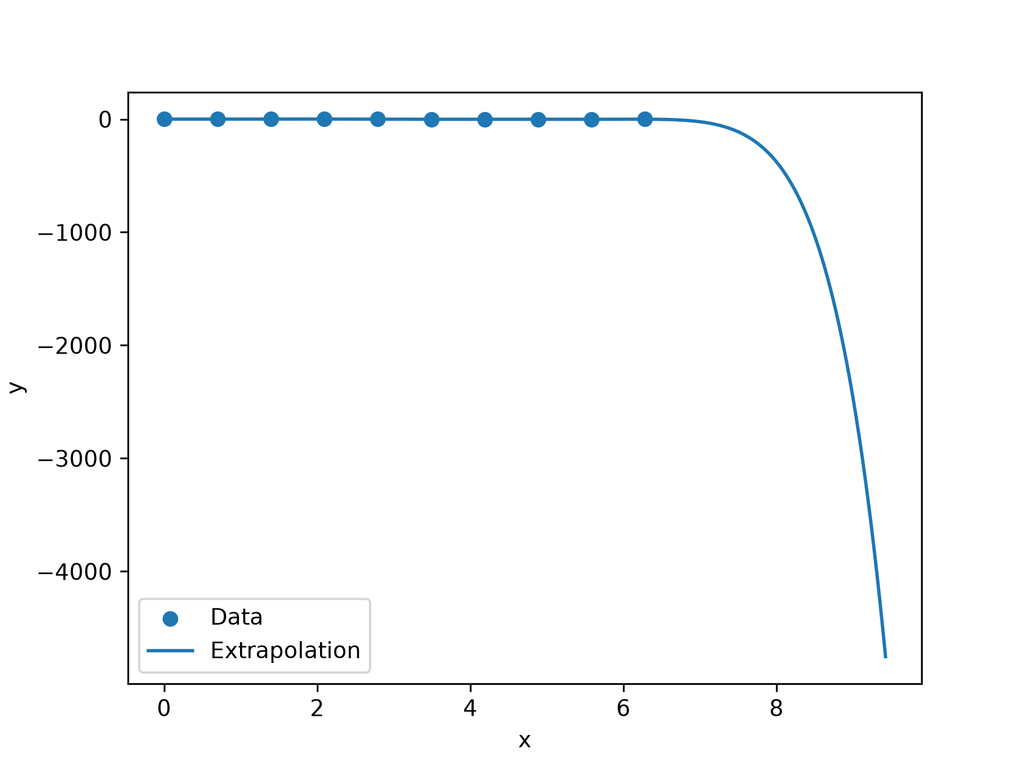
値が-4000まで到達していて思いっきり外れてしまいました。
汎化性能が壊滅的
フィッティングを行う目的はなんでしょうか?その一つに予測があります。
10個のデータ点から$x$と$y$の関係をフィッティングしたとします。
例えば、データが得られていない$x=0.5\pi$だったり、$x=11\pi$のときにどういう$y$の値が得られるかを予測したいのです。
$x=11\pi$のケースは、先ほど見たように外挿した場合に相当し、予測精度は壊滅的です。
$x=0.5\pi$は補間に相当します。
9次式は、データ範囲内の$x=0.5\pi$でもノイズに適合してしまうため、未知のデータに対する予測性能が悪くなります。
ここで関係する言葉として汎化性能があります。
汎化性能とは、フィッティングに使用していない未知のデータに対して、どれだけうまく予測できるかを表すものです。
また、学習データに適合しすぎて、未知のデータに対する予測性能が低下した状態を過学習といいます。
汎化性能と過学習は使いこなせるとかっこよく見える言葉です。
係数の意味が分かりづらい
フィッティングには、データを再現するだけでなく、得られたパラメータから現象を理解するという目的もあります。
例えば、光のパワーをセンサーで測るようなケースを考えてみます。
センサーに入る光量をx、センサー出力をyとします。
このとき、以下の式でフィッティングします。
$$
y= ax +b
$$
$a$はセンサ出力と実際の光量の変換係数として使えます。
また$b$は本来0ですが、0でなければ何らかの理由で測定にオフセットが乗っている、などと判断できます。
上記で得られた9次式では、10個の係数が得られます。
では、9次式の10個の係数それぞれに、同じような意味を持たせることができるでしょうか?
print(coef)[ 5.26949395e-05 -5.43393953e-03 1.17486903e-01 -1.13825832e+00
5.88443211e+00 -1.69200589e+01 2.62094970e+01 -1.98380871e+01
6.25827763e+00 1.49014246e-01]
多くの場合でこの情報の解釈、活用はとても難しいです。
当然、データの性質によっては9次式フィッティングが正当化されることもあり得ます。
じゃあ何次式にすればいいの?
9次は流石にやり過ぎ感があるので、次数を下げることを考えると思います。
では何次にすればいいのでしょうか?
こう次数を決めればいいという万能なものは存在しません。
機械学習の文脈だと、未知のデータに対する予測性能を重視しており、汎化性能の良いモデルを選ぼうとなります。
統計モデリング的な文脈だと、データの背後にあるメカニズムを説明することを目的とします。
予測を目的とするのか、現象の説明を目的とするのかで、重視するものが少し変わります。
そして、適切に人に説明できるかという点はどういう立場であろうと常に重要です。
まとめ
9次式フィットは$R^2=1$でしたが、未知のデータに対する予測性能は低く、係数の解釈も困難でした。
$R^2$だけではフィット関数の良し悪しの判断できないという良い例です。
次回記事
散々ダメだと言いましたが、それでも9次式フィッティングをしたい!
正則化でチャレンジします。
参考文献
統計モデリングについての名著です。
著者の久保先生は元々数学の立場で統計専攻していましたが、実際のデータを使って統計解析を行う研究室に移ったそうです。理論だけでない実際のデータに向かい合って、一つずつ理解を積み上げた者でないと出せない言葉や雰囲気が全編にわたって充満していて、それが名著たらしめています。
機械学習の理論的な側面を学ぶのに定番の教科書です。
詳細を知りたくなった時に確認するのに丁度良く、機械学習を学びたい、使いたいと思っている方には必携の書です。
コメント