はじめに
前回記事にて、データ点が10点の時に9次式でカーブフィッティング(曲線近似)を行いました。
当然ながら、過学習となりNGでした。
それでもやはり9次式で上手くフィットしてみせたい!!と思ったので、
フィット方法を修正して再度9次式フィットに挑戦します。
Ridge回帰とLasso回帰について理解できるようになります。
前回記事
前回結果の分析
前回は通常通りフィットした結果は下図でした。
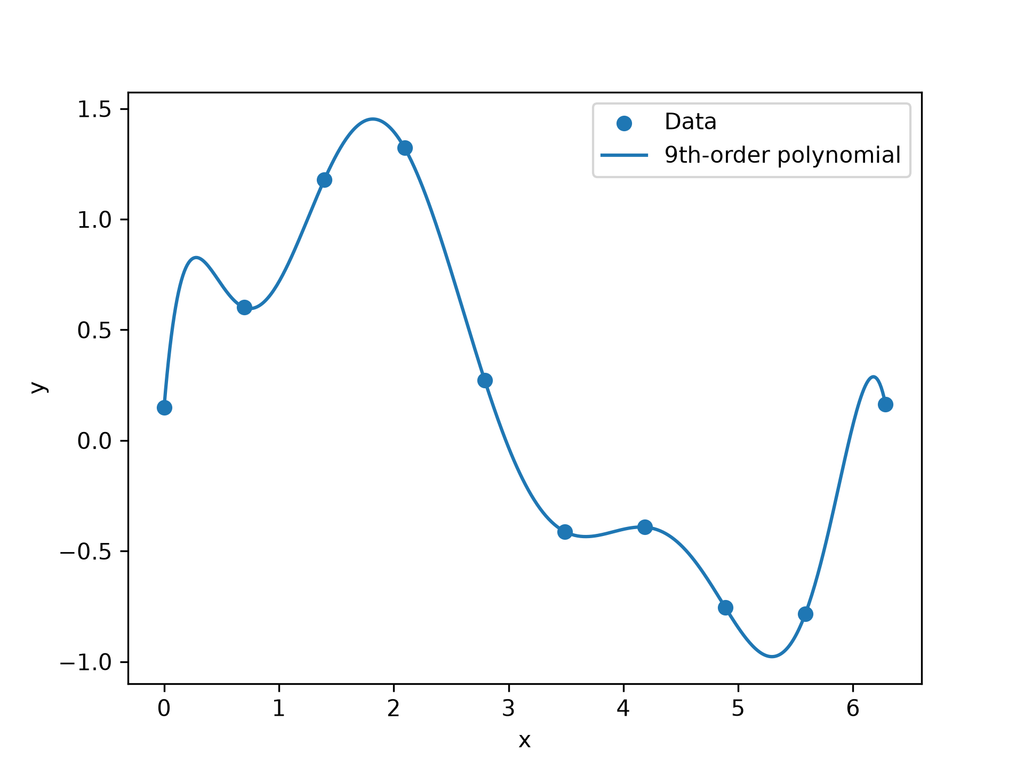
見ての通り、ノイズにも適合するため式がぐにゃぐにゃしています。
このデータはsin関数にノイズを乗せたものでした。
それでは、9次フィットした時にどういう係数であれば適切と言えるでしょうか?
テイラー展開と比較して考えてみましょう
sin関数はテイラー展開から、下式で書けます。
$$
sin(x) = x-\frac{x^3}{3!}+\frac{x^5}{5!}….
$$
各項の係数は1よりも小さく、更に次数が上がるほど小さくなっていくような傾向があります。
前回のフィッティングで得られた9次式の係数を確認してみましょう
[ 5.26949395e-05 -5.43393953e-03 1.17486903e-01 -1.13825832e+00
5.88443211e+00 -1.69200589e+01 2.62094970e+01 -1.98380871e+01
6.25827763e+00 1.49014246e-01]
テイラー展開と直接比較は出来ないものの、フィット係数は20を超えるようなものもあり、値の絶対値が大きいようです。
9次多項式は係数同士が激しく打ち消し合うことで、データ点にはよくフィットできてしまっているようにみえます。
そうであればフィッティング方法に修正を加えて、係数が大きくなりすぎないようにするのが良さそうです。
フィッティング方法について
フィッティングは、一般的に最小二乗法を用います。
フィッティング関数を$f(x)$とします。9次式を用いるので下式です。
$$
f(x)= a_0+a_1x+a_2x^2+….a_{9}x^{9}
$$
$a_0,a_1,,,a_9$の値が決まれば関数が決定します。
データは$y$と$x$がそれぞれ10点あるので、$y=y_0,y_1,,,,y_9$と$x=x_0,x_1,,,,x_9$と書けます。
フィッティングは、下量を最小とするという条件から$a_0,a_1,,,a_9$を求めます。
$$
\sum_{i=0}^9(y_i-f(x_i))^2
$$
今の状況では、$a_0,a_1,,,a_9$の値を大きくしたくないので、下量に修正します。
$$
\sum_{i=0}^9(y_i-f(x_i))^2 +\lambda\sum_{k=1}^9a_k^2
$$
第2項が係数を大きくすることに対する罰則を表せます。
$\lambda$は定数であり、罰則の大きさを調整する役割を持ちます。
$\lambda=0$とすると通常の最小二乗法となることが分かります。
Ridge回帰
先ほど話したフィッティング方法は、Ridge(リッジ)回帰と呼ばれるものです。
scikit-learnで実装されているので、それを使って次節からフィットしてみます。
フィッティング
前節で説明したRidge回帰を実施します。
コード中のalphaが前節で説明した$\lambda$とほぼ対応します。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import Ridge
from sklearn.pipeline import make_pipeline

# データ作成
np.random.seed(42)
x = np.linspace(0, 2*np.pi, 10)
y_true = np.sin(x)
noise = np.random.normal(0, 0.3, size=x.shape)
y = y_true + noise

#Ridge回帰
alphas=[0,1,10,100]
xx = np.linspace(0, 2*np.pi, 500)
result=[]
for alpha in alphas:
    # 9次多項式 + Ridge
    model = make_pipeline(
        PolynomialFeatures(degree=9,include_bias=False),
        Ridge(alpha=alpha)
    )
    model.fit(x[:, None], y)

    yy = model.predict(xx[:, None])
    result.append(yy)


plt.scatter(x, y,label="Data")

for i in range(len(alphas)):
    plt.plot(xx, result[i],label=f"{alphas[i]}")

plt.legend()
plt.show()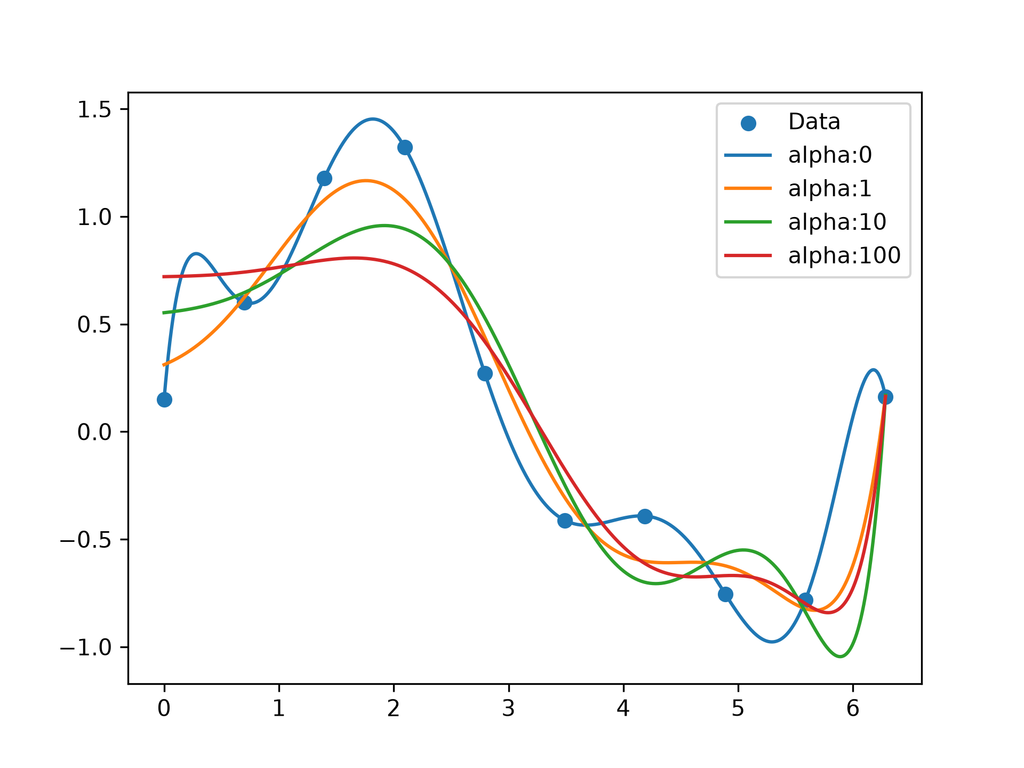
alphaが0の時は通常のフィッティングであり、alphaを大きくするにつれてデータへの追随が緩くなっていく様子が見えます。
今の場合だと、正解を知っているので、10辺りが一番いいように見えます。
外挿してみる
alpha=10のときに外挿してみます。$(0,2\pi)$の範囲でしたが$(0,3\pi)$に広げてみます。
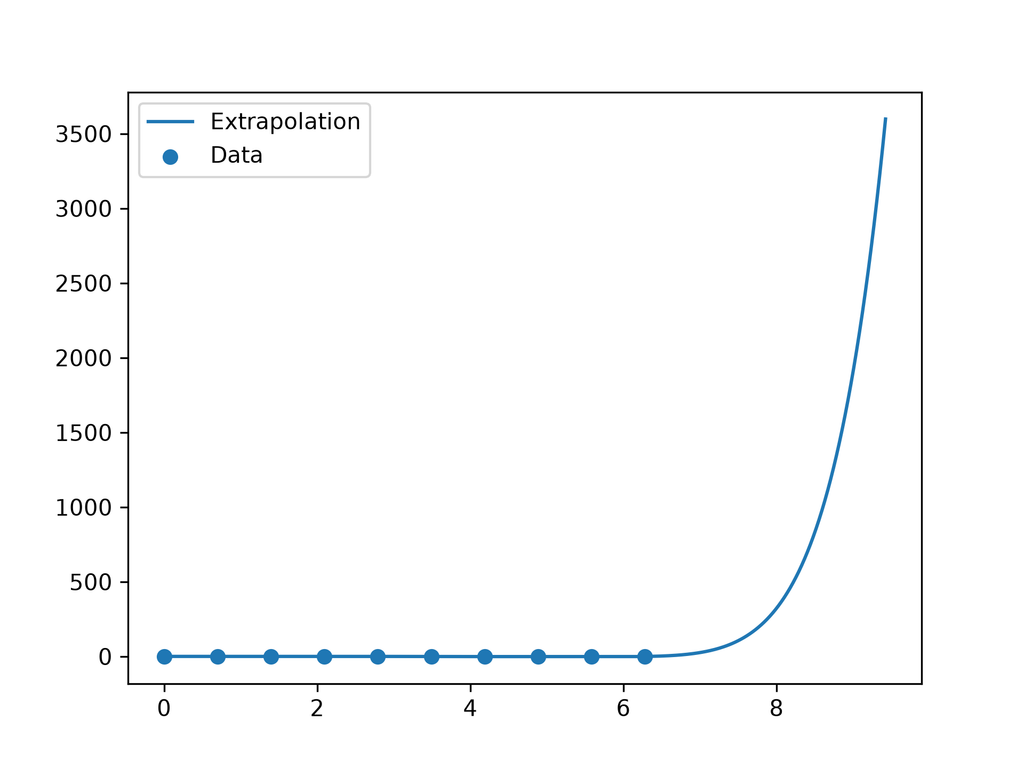
大きく外れてしまいました。Ridge回帰しても外挿はやはり難しいようです。
前回やった通常フィットでは-4000以下になっていたので、Ridge回帰で係数の大きさを制限した効果が若干ありそうな感じはします。
Lasso(ラッソ)回帰
Ridge回帰と近い手法として、Lasso回帰があります。
Lasso回帰は下量を最小化します。
$$
\sum_{i=0}^9(y_i-f(x_i))^2 +\lambda\sum_{k=1}^9|a_k|
$$
殆ど一緒に見えますが、第2項の$a_k$が2乗でなく絶対となっています。
Lasso回帰では$a_k$の値が0となること多くなる傾向があり、特定次数を選択するような効果があります。
まとめ
リッジ回帰の方法について解説し、実際にフィットを行いました。
$\lambda$の値を大きくするにつれて、データへの追随が緩くなっていくことを確認しました。
次回記事
ここまで意地を張って9次式フィットをやりましたが、やはり次数を下げるのが素直だと感じます。
AICを使って次数を議論してみたいと思います。
参考文献
PRMLとも略される機械学習、ベイズ統計についての定番の教科書です。
邦訳も出ているのが有難いです。
コメント