はじめに
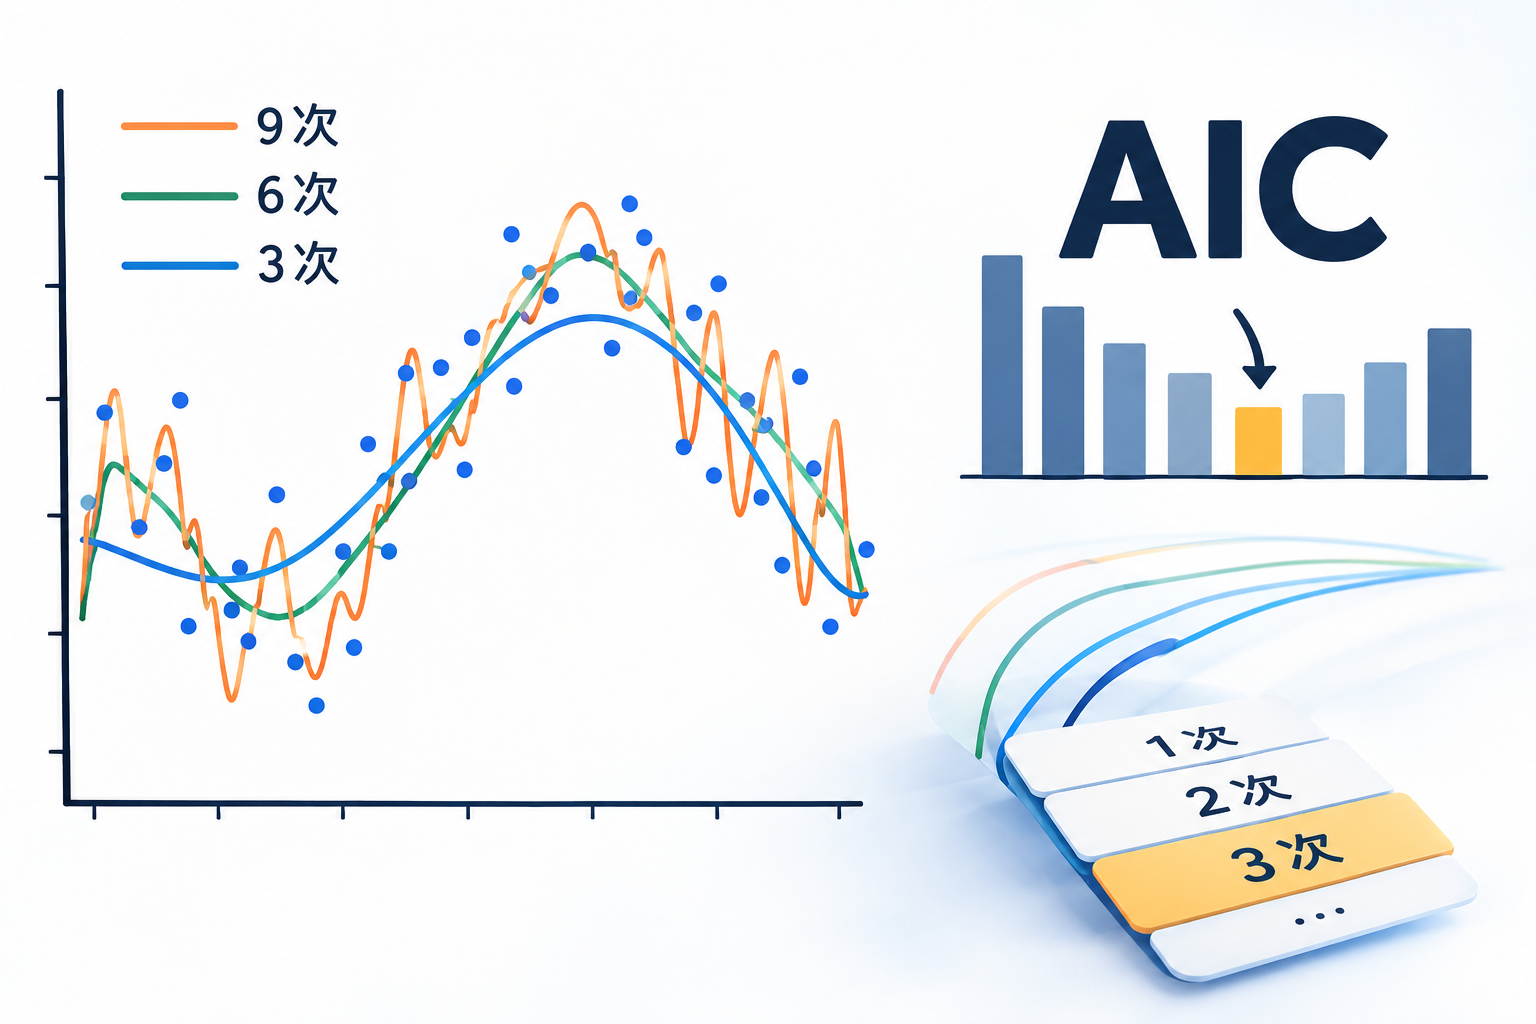
前回まで10点データに対して、次数を落とさず9次式を使ってカーブフィッティング(曲線近似)を行いました。
今回は意地を張らずに次数を落としてフィッティング行います。
問題は次数を幾つに落とすか?であり、情報量基準(AIC,Akaike’ information criterion)を活用します。
前回記事
問題状況の確認(おさらい)
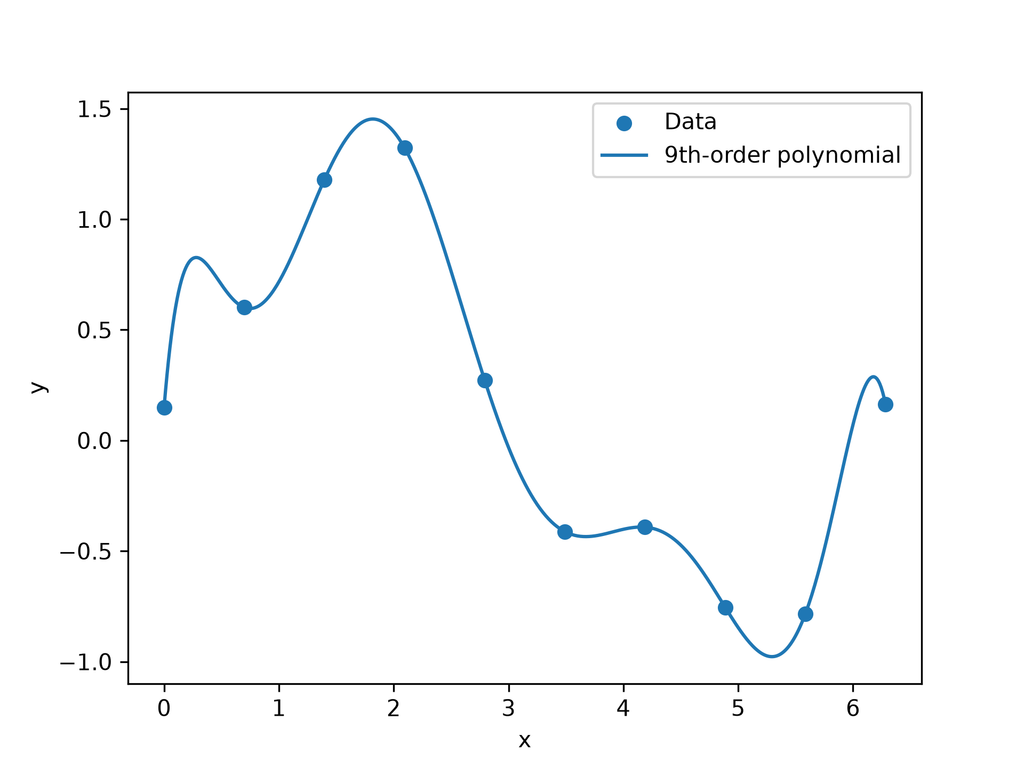
ダミーデータとして、sin関数にノイズを乗せたデータを10点生成しました。
9次式でフィットすると下図のようになります。ぐにゃぐにゃします。
フィットモデル再考
フィット関数を$f(x)$とします。
今回は次数を最適化するので、$f(x)$は1~9次式のいずれかです。
データが$y$と$x$の組み合わせとすると、以下の関係を仮定しています。
$$
y=f(x)
$$
実際のデータには必ず誤差が乗っています。
誤差は一般に平均値が0、分散が$\sigma^2$の正規分布で扱うことが出来るので、フィット式を修正します。
関連記事:https://yohaku-labs.com/neko-normal-distribution/
$$
y= f(x)+\varepsilon,\varepsilon \sim N(0,\sigma^2)
$$
$\varepsilon$が誤差を表します。
全く同じ意味で、下式のように書けます。
$$
y\sim N(f(x),\sigma^2)
$$
$\sim$は確率分布であることを表します。
これまでは、データとフィット式のずれを小さくするという考え方でしたが、
上式に書き換えることで、フィット式を確率分布で扱えるようになりました。
尤度関数
1点のデータ$(x_i,y_i)$が得られたとします。
このデータが得られる確率は、下式で表せます。
$$
N(f(x_i),\sigma^2)\Delta y
$$
正規分布は連続関数なので、値に対して幅$\Delta y$をかける必要があります。
手元にある10点分のデータが得られる確率は下式となります。
$$
L=N(f(x_0),\sigma^2)\cdot N(f(x_1),\sigma^2) \ldots N(f(x_9),\sigma^2) (\Delta y)^{10}
$$
この式$L$は尤度関数と呼ばれるものです。
尤度関数$L$は手元にあるデータが得られる確率に対応し、これを最大化することで$f(x)$の係数を求めることが出来ます。
$\Delta y$は値がはっきりせず気持ち悪い感じがしますが、後節で解説するように尤度関数はlogをとるため実際の計算では無視できます。
今回のように誤差が正規分布に従うと仮定した場合、尤度を最大化することと、残差二乗和を最小化することは同じ結果になります。
つまり、これまで使っていた最小二乗法も、確率モデルの立場から見ることができるのです。
やりたいことは、$f(x)$の次数を決めることでした。
尤度関数最大化は、係数の値を決められますが次数は求まりません。
どうすればいいのでしょうか?
情報量基準(AIC)
フィット関数の次数を上げるほど、データへのあてはまりが良くなり尤度も大きくなります。
データへの当てはまりだけでなく、モデルの複雑さも考慮してモデルを選ぶ指標がAICです。
$$
AIC = -2lnL_{max}+2k
$$
$k$はフィット関数のパラメータ数です。今回のケースでは$k$フィット関数の次数+2です。
m次式はm+1個のパラメータを持ち、更に誤差の大きさ$\sigma$を用いるためです。
第1項はフィットのあてはまりの良さ、第2項はモデルの複雑さを表しそのバランスを表しています。
そして、このAICが一番小さくなる次数を選択してみましょう。
尤度と裕度
尤度は聞き慣れない言葉で英語でlikelihood、”あり得る”というような意味です。
裕度は”余裕がどの程度あるか”という意味です。仕様に対して実物はどの程度余裕があるかという文脈でよく見ます。
これらはよく混同されるので注意が必要です。
AICを計算してみる
AICの式中の$L$はフィット関数のパラメータ最適化で最大化したときの値を意味します。
式を整理します。
$$
L=\prod^n_{i=1}\frac{1}{\sqrt{2\pi\sigma^2}}\exp\Big(-\frac{(y_i-f(x_i))^2}{2\sigma^2}\Big)
$$
整理すると下式になります。
$$
L=(2\pi\sigma^2)^{-\frac{n}{2}}\exp(-\frac{RSS}{2\sigma^2})
$$
ここで
$$
RSS = \sum_{i=1}^n(y_i-f(x_i))^2
$$
対数をとります。
$$
logL = -\frac{n}{2}log(2\pi\sigma^2)-\frac{RSS}{2\sigma^2}
$$
この式から、尤度関数の最大化とRSSを最小化することが同じだと分かります。
最小二乗法でフィットした後では下式が成り立ちます。
$$
\sigma^2=\frac{RSS}{n}
$$
よって最大化した尤度関数$L_{max}$に対して下記が成立します
$$
logL_{max}=-\frac{n}{2}(log(2\pi\frac{RSS}{n})+1)
$$
def calculate_aic(x, y, degree):
    # 多項式フィット
    coeff = np.polyfit(x, y, degree)
    y_fit = np.polyval(coeff, x)

    # 残差二乗和
    rss = np.sum((y - y_fit)**2)

    # データ数
    n = len(y)

    # 推定パラメータ数
    # 多項式係数: degree + 1
    # 誤差分散: 1
    k = degree + 2

    # 最大尤度推定された分散
    sigma2 = rss / n

    # AIC
    aic = n * np.log(2 * np.pi * sigma2) + n + 2 * k

    return aic
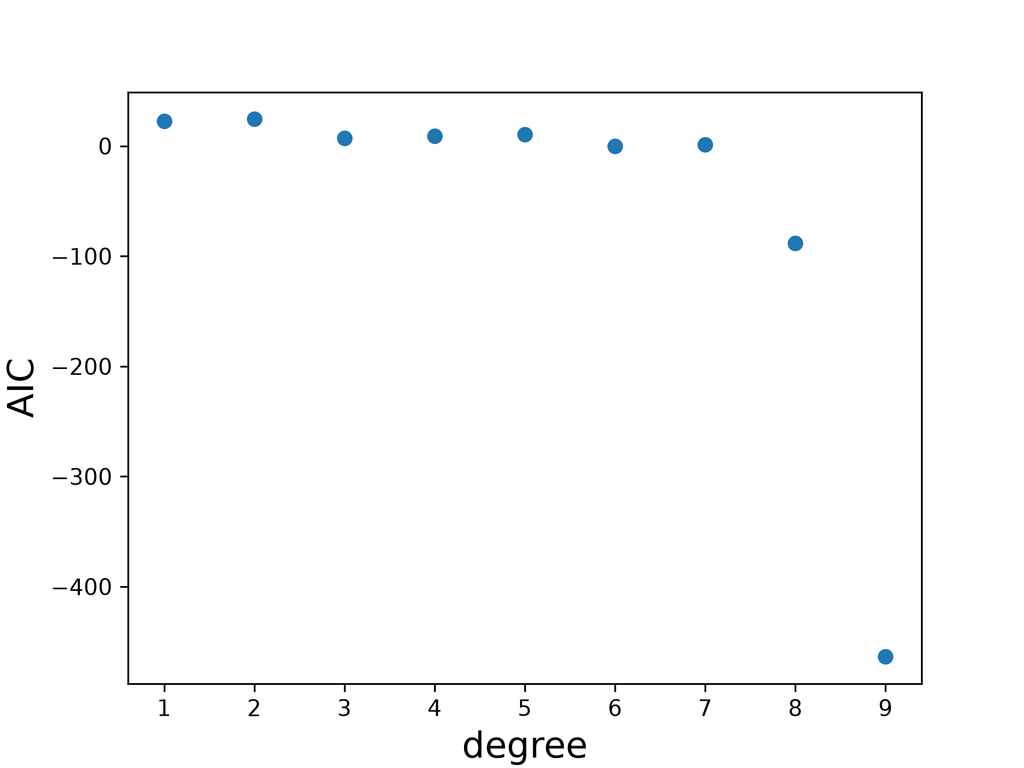
意外にも9次式がAICが最も小さくなりました。
9次式だと、RSSが0となるためこの寄与が大きかったものと思います。
実はAICはデータ点が十分に多いことが前提とされており、本条件では上手く計算出来ないのです。
計算出来ませんでしたでは寂しいので試しに、1-7次の範囲を見てみます。
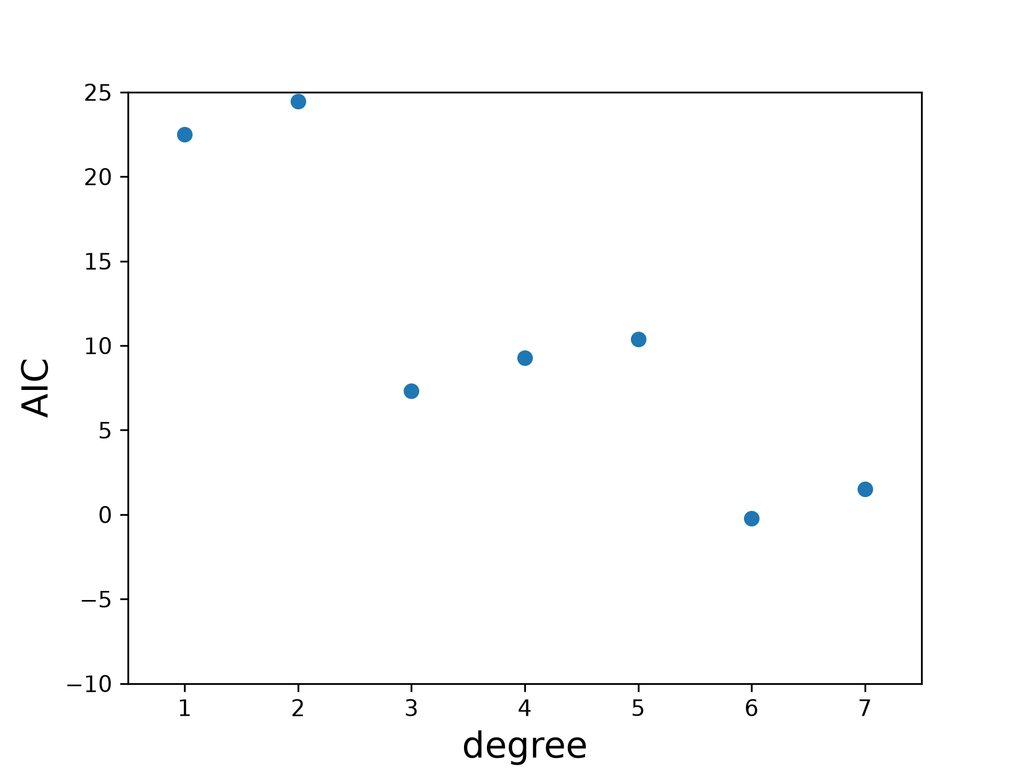
6次がAIC最小となっています。
ただ6次(パラメータ8個)もやり過ぎな気がするので、極小値ぽくなっている3次式フィットでもいいような気がします。
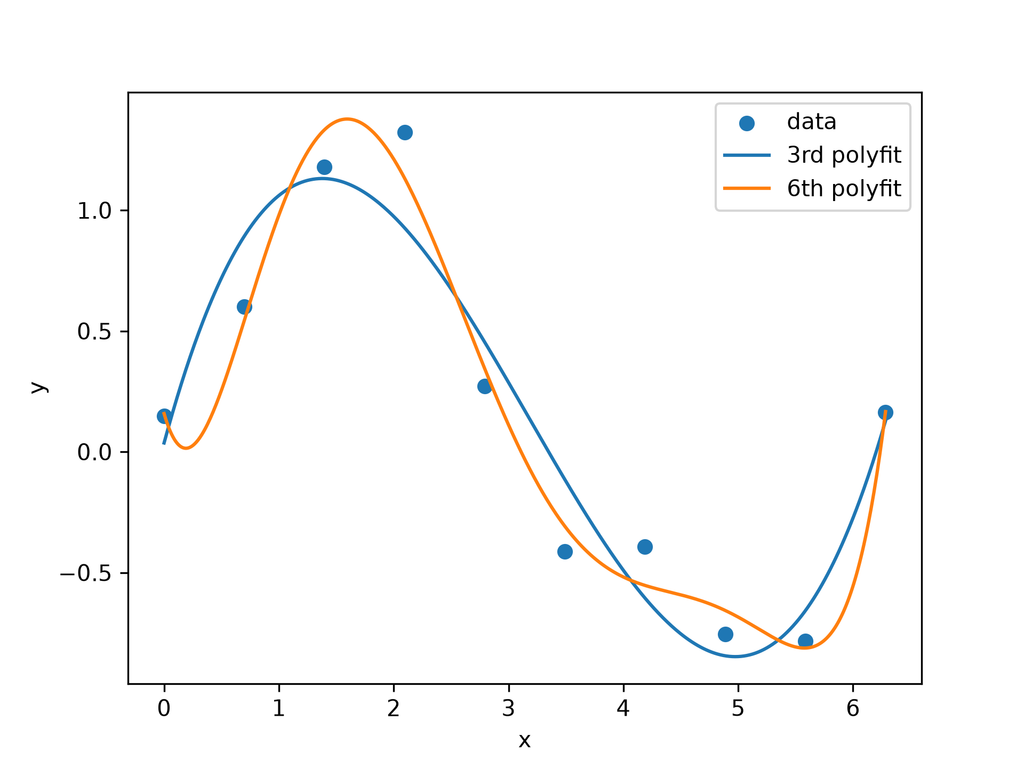
3次と6次のフィットを確認します。
これをみるとぐにゃぐにゃした感じが少ない3次フィットがいい気がします。
まとめ
10点データに対する最適な次数をAICを使って考察しました。
9次式ではRSSが0近くなるため、AICが非常に小さくなってしまいました。
これはAICの十分データ点が多いという前提を満たしていないためです。
今回の場合、AICさえ確認すればいいという単純な話ではなく、
自分でいろいろな視点で見てケースごとに判断が必要でした。
また、ダミーデータなのでドメイン知識を活用できなかったのもあります。
参考文献
統計モデリングについての名著です。
著者の久保先生は元々数学の立場で統計専攻していましたが、実際のデータを使って統計解析を行う研究室に移ったそうです。理論だけでない実際のデータに向かい合って、一つずつ理解を積み上げた者でないと出せない言葉や雰囲気が全編にわたって充満していて、それが名著たらしめています。
PRMLとも略される機械学習、ベイズ統計についての定番の教科書です。
邦訳も出ているのが有難いです。
コメント